ChatGPT, Claude und Gemini haben einen Nebeneffekt: Alles, was du ihnen schreibst, verlässt deinen Rechner. Dabei ist ausgerechnet der Mac eine der besten Maschinen, um Sprachmodelle komplett lokal zu betreiben. Ohne Cloud, ohne Konto, ohne dass ein Prompt das Haus verlässt. Was geht da realistisch, und wo wird es zäh?
Warum Apple Silicon dafür taugt
Zwei Eigenschaften machen den Unterschied. Erstens der Unified Memory: CPU und GPU teilen sich denselben Speicher. Ein Mac mit 32 GB RAM kann ein 28-GB-Modell direkt in die GPU-Inferenz nehmen, ohne das Hin- und Herkopieren zwischen Grafikspeicher und Hauptspeicher, an dem PC-Setups mit begrenztem VRAM scheitern.
Zweitens die Speicherbandbreite, der eigentliche Flaschenhals beim Generieren: Für jedes erzeugte Token müssen die Modellgewichte einmal durch den Speicher gestreamt werden. Deshalb zählt hier nicht die reine GPU-Leistung, sondern GB/s. Und da liegen zwischen einem Basis-M4 (rund 120 GB/s) und einem M4 Max (rund 546 GB/s) Faktor vier bis fünf bei der Token-Rate. Ein M4 Max mit 64 GB schafft ein 70-Milliarden-Parameter-Modell mit gut lesbaren ~12 Token pro Sekunde.
Was bei wie viel RAM läuft
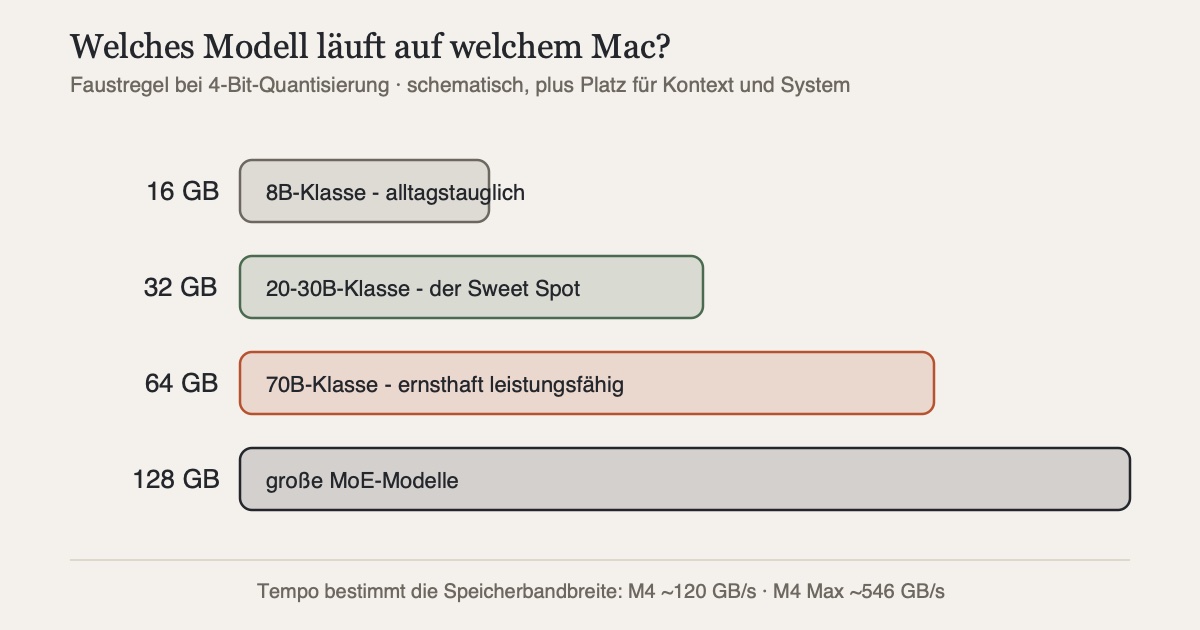
Die Faustregel: Ein Modell in 4-Bit-Quantisierung belegt etwa ein halbes Gigabyte pro Milliarde Parameter, plus Platz für Kontext und System. Daraus ergibt sich eine ehrliche Treppe:
- 16 GB: Die 7-8B-Klasse (Llama, Qwen, Gemma in klein) läuft flott und alltagstauglich. OpenAIs gpt-oss-20b ist offiziell für 16 GB ausgelegt, in der Praxis ist das aber die absolute Untergrenze. Sobald macOS und ein Browser mit um den Speicher konkurrieren, wird es quälend langsam
- 32 GB: Der Sweet Spot für Einsteiger mit Ambitionen. Die 20-30B-Klasse läuft komfortabel, gpt-oss-20b flüssig, daneben bleibt Luft für die eigentliche Arbeit
- 64 GB und mehr: Die 70B-Klasse wird nutzbar. Modelle, die vor zwei Jahren noch Rechenzentrums-Hardware brauchten, laufen im MacBook. Mit 128 GB sind auch große Mixture-of-Experts-Modelle drin
Die Werkzeuge
- Ollama ist der einfachste Einstieg: installieren,
ollama run gpt-oss:20b, fertig. Modellbibliothek inklusive, offiziell von OpenAI dokumentiert - LM Studio (lmstudio.ai) bietet dasselbe mit grafischer Oberfläche, Modell-Browser und lokalem API-Server; damit lassen sich verschiedene Modelle gut vergleichen
- MLX, Apples eigenes Open-Source-Framework für Apple Silicon, holt mit mlx-lm oft noch etwas mehr Tempo heraus und kann Modelle auch lokal feintunen
Was lokal wirklich gut geht
Lokale Modelle der 8-30B-Klasse sind inzwischen erstaunlich brauchbar für: Zusammenfassen und Umformulieren, Übersetzungen, Fragen an eigene Dokumente, Code-Vervollständigung und Commit-Messages, strukturierte Extraktion aus Texten. Der eigentliche Trumpf ist aber ein anderer: Vertrauliches bleibt vertraulich. Vertragsentwürfe, Gesundheitsfragen, Kundendaten, unveröffentlichter Code: Alles, was man einem Cloud-Dienst nicht anvertrauen möchte, ist beim lokalen Modell schlicht kein Risiko. Außerdem funktioniert es offline, im Flugzeug genauso wie hinter einer restriktiven Firmen-Firewall, und kostet nach dem Kauf des Macs nichts mehr.
Wo die Grenzen liegen
Ehrlich gesagt ist ein lokales 20B-Modell kein Ersatz für die Frontier-Modelle aus der Cloud. Bei komplexem Schlussfolgern, langen Recherchen und anspruchsvollem Code merkt man den Abstand deutlich. Lange Kontexte (ganze Codebasen, hundertseitige PDFs) sind zusätzlich ein Geduldsspiel, weil die Verarbeitung des Prompts auf Apple Silicon vergleichsweise langsam ist. Und auf dem MacBook gilt: Dauerbetrieb zieht spürbar am Akku und macht den Lüfter hörbar.
Realistisch betrachtet ersetzen lokale Modelle die Cloud nicht, sie ergänzen sie. Alles Private, Schnelle und Wiederkehrende läuft lokal, für die harten Nüsse bleibt das große Modell.
Fazit
„Was schafft mein Mac?“ lässt sich inzwischen präzise beantworten: 16 GB reichen zum Ausprobieren der 8B-Klasse, 32 GB machen lokale KI alltagstauglich, ab 64 GB wird es ernsthaft leistungsfähig. Die Einstiegshürde ist ein einziger Ollama-Befehl. Wer einmal erlebt hat, wie ein Sprachmodell komplett ohne Internetverbindung antwortet, ohne dass dabei ein einziges Wort den Rechner verlässt, versteht, warum lokale KI mehr ist als eine Spielerei.
Quellen
- Ollama: gpt-oss:20b in der Modellbibliothek, offizielle Anforderungen und MXFP4-Quantisierung
- OpenAI Developers: How to run gpt-oss locally with Ollama, offizielle Anleitung inklusive 16-GB-Empfehlung
- The Register: How to run OpenAI's new gpt-oss-20b LLM on your computer, Praxiserfahrungen und warum 16 GB die Untergrenze sind
- ML Journey: Apple Silicon for LLMs: M3 vs M4 Max vs M4 Ultra, Speicherbandbreiten und Token-Raten im Vergleich
- GitHub: ml-explore/mlx und ml-explore/mlx-lm, Apples Open-Source-Framework für ML auf Apple Silicon