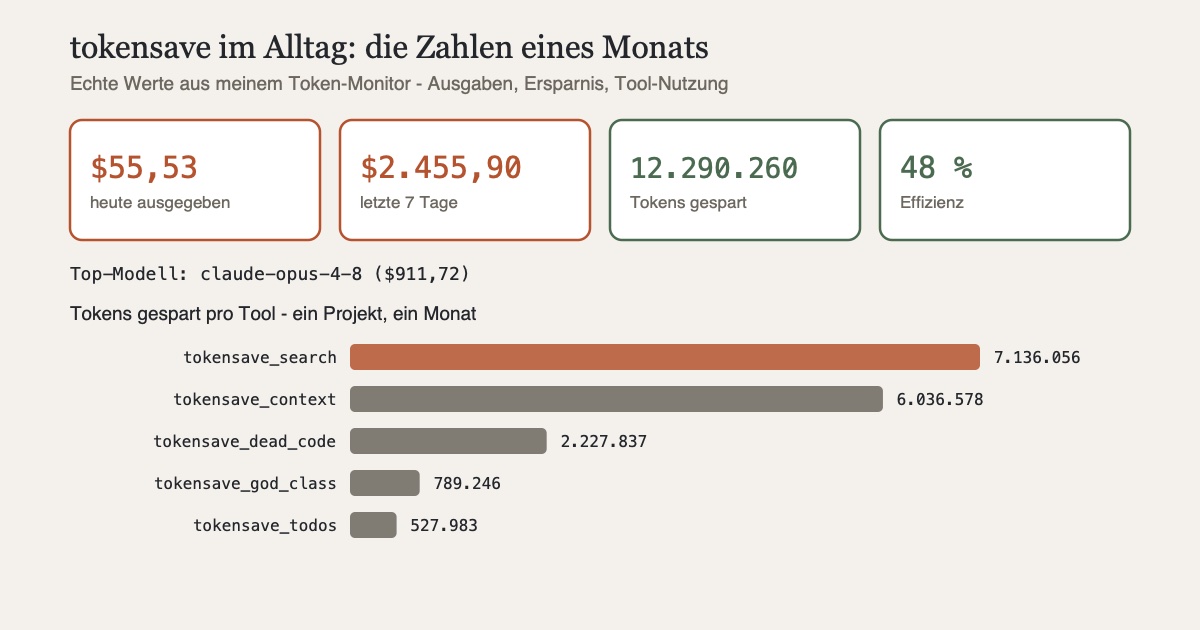
Seit ein paar Wochen läuft in meinen Projekten ein Tool mit, das im Alltag unsichtbar ist - bis man auf den Zähler schaut. Über 12 Millionen Tokens hat tokensave bei mir inzwischen eingespart. Es ist ein MCP-Server, der Claude Code einen lokalen Code-Graphen zur Verfügung stellt, statt das Modell ganze Dateien lesen und sich textbasiert durchs Repository suchen zu lassen. Was es kann, wie es unter der Haube funktioniert, was ein reproduzierbarer Benchmark dazu sagt - und wo die Grenzen liegen.
Kurzer Exkurs: Warum Tokens die Währung sind
Sprachmodelle lesen und schreiben nicht in Zeichen oder Wörtern, sondern in Tokens - Wortbruchstücken von grob drei bis vier Zeichen. Alles, was ein KI-Assistent zu sehen bekommt, zählt: die eigene Frage, die Systemanweisungen, vor allem aber jede Datei und jedes Suchergebnis, das er sich in den Kontext lädt. Eine Quelldatei mit 1.000 Zeilen kostet als Größenordnung um die 10.000 Tokens - pro Anfrage, denn das Kontextfenster wird bei jedem API-Aufruf neu übermittelt.
Das hat zwei Konsequenzen. Erstens Geld: Abgerechnet wird pro Token, üblicherweise in Preisen je Million. Wer den Assistenten für jede Codefrage halbe Repositories lesen lässt, bezahlt dafür. Zweitens Qualität: Das Kontextfenster eines Modells ist begrenzt - bei aktuellen Modellen zwischen 200.000 und einer Million Tokens -, und je voller es mit irrelevantem Code ist, desto weniger Platz bleibt für das, worauf es ankommt.
Wie ein Modell Text zerlegt - und warum Code teuer ist
Die Zerlegung in Tokens übernimmt ein Tokenizer, meist auf Basis von Byte Pair Encoding (BPE): Das Verfahren lernt aus großen Textmengen, welche Zeichenfolgen häufig zusammen auftreten, und fasst sie zu je einem Token zusammen. Häufige englische Wörter sind ein einziges Token, seltene zerfallen in mehrere. Daraus folgen drei Dinge, die man beim Sparen kennen sollte:
Erstens tokenisiert Code anders als Prosa. Einrückungen, Klammern und Sonderzeichen sind eigene Tokens, und ein Bezeichner wie getUserAccountBalance zerfällt in mehrere Bruchstücke - Quellcode ist pro Zeichen oft teurer als Fließtext. Zweitens ist Deutsch teurer als Englisch: Tokenizer werden überwiegend auf englischen Texten trainiert, lange deutsche Komposita zerfallen entsprechend feiner. Und drittens sind Token-Zahlen zwischen Modellgenerationen nicht vergleichbar - ein neuer Tokenizer kann denselben Text um rund ein Drittel anders zählen. Die Faustregel „1.000 Zeilen ≈ 10.000 Tokens" ist deshalb genau das: eine Faustregel.
Weniger Kontext ist nicht nur billiger - er macht Antworten besser
Man könnte einwenden: Die Kontextfenster werden doch immer größer, warum überhaupt sparen? Weil große Kontexte ein dokumentiertes Qualitätsproblem haben. Liu et al. haben 2023 in „Lost in the Middle: How Language Models Use Long Contexts" gezeigt, dass Sprachmodelle Information am Anfang und Ende eines langen Kontexts deutlich zuverlässiger nutzen als Information in der Mitte - die Abrufgenauigkeit bricht dort messbar ein.
Für Codefragen heißt das: Wer dem Modell drei komplette Dateien in den Kontext kippt, von denen 95 Prozent irrelevant sind, bezahlt nicht nur für die irrelevanten Tokens - er riskiert auch, dass die relevante Stelle in der Mitte des Kontexts untergeht. Weniger, dafür treffendere Tokens sind also kein reiner Sparzwang, sondern ein Qualitätshebel.
Was ist tokensave?
Wer einem KI-Assistenten beim Programmieren zusieht, kennt das Muster: Für die Frage „Wo wird diese Funktion überall aufgerufen?" liest er erst einmal drei Dateien komplett und grept sich dann durchs halbe Repository. Das funktioniert - kostet aber jedes Mal tausende Tokens, von denen die meisten nichts zur Antwort beitragen.
tokensave (github.com/aovestdipaperino/tokensave, MIT-Lizenz, rund 450 Stars auf GitHub) setzt genau dort an: Statt Code als Text zu durchsuchen, beantwortet es Fragen über die Struktur des Codes - aus einem lokalen Graphen, der einmal aufgebaut und dann gezielt abgefragt wird. Unterstützt werden laut Projekt 34 Programmiersprachen, von Rust über Python und TypeScript bis Swift.
Wie der Code-Graph funktioniert
Beim Indizieren zerlegt tokensave die Codebase in ihre Bausteine: Funktionen, Methoden, Typen, Module werden zu Knoten, ihre Beziehungen - wer ruft wen auf, wer importiert was - zu Kanten. Das Ergebnis landet als libSQL-Datenbank (ein SQLite-Fork) im Projektordner. Wer hineinschaut, findet mehr als nur die Kerntabellen nodes, edges und files: einen FTS5-Volltextindex für die Symbolsuche, eine vectors-Tabelle mit Embeddings für semantische Ähnlichkeit und Fingerprint-Tabellen, über die der inkrementelle Sync erkennt, welche Dateien sich geändert haben - ein Sync nach kleinen Änderungen dauert bei mir gemessene 21 Millisekunden.
Diese Architektur erklärt, warum die Abfragen so billig sind: Der teure Teil - Parsen, Indizieren, Embedden - passiert einmal beim Init. Danach ist jede Frage nur noch ein Datenbank-Lookup. Fragt der Assistent klassisch „Wo wird parse_config aufgerufen?", muss er Dateien lesen oder Grep-Treffer samt Umgebung in den Kontext laden. Mit tokensave stellt er dieselbe Frage an den Graphen und bekommt eine Liste der Aufrufstellen zurück, plus auf Wunsch genau die betroffenen Codeausschnitte: ein paar hundert Tokens statt tausender.
Darauf aufbauend gibt es einen ganzen Werkzeugkasten: Symbolsuche, Aufrufketten über mehrere Ebenen, Impact-Analyse („was ist betroffen, wenn ich das ändere?"), Dead-Code-Erkennung. Für komplexere Strukturfragen lässt sich die Datenbank sogar direkt per SQL abfragen.
Was der Graph nicht sieht
So ehrlich muss man sein: Ein statisch aufgebauter Graph kennt nur, was sich statisch auflösen lässt. Dynamischer Dispatch, Reflection, Duck Typing in Python, Makros - alles, was erst zur Laufzeit entschieden wird, taucht als Kante nicht auf. Mein eigenes Website-Projekt illustriert das: Der Graph enthält 1.115 Knoten, aber nur 252 Kanten, allesamt Funktionsaufrufe. Bei einer kleinen Python- und JavaScript-Codebase mit viel dynamischem Kleber bleibt das Beziehungsnetz also lückenhaft; in einer großen, statisch typisierten Rust- oder Java-Codebase sähe das Verhältnis deutlich anders aus.
Praktisch heißt das: Für „Wo ist Symbol X definiert und wer ruft es direkt auf?" ist der Graph exzellent. Für „Welcher Handler wird über diese Config-Datei zur Laufzeit registriert?" hilft er nicht - da bleibt es beim klassischen Lesen. tokensave ersetzt Code-Verständnis nicht, es macht die häufigsten Navigationsfragen billig.
Setup in fünf Minuten
Die Einrichtung ist unspektakulär:
- Installieren über crates.io, Homebrew oder als Prebuilt-Binary; landet z. B. unter
~/.local/bin/tokensave. tokensave initim Projektordner legt.tokensave/tokensave.dban und indiziert den Code.tokensave installregistriert das Tool als MCP-Server in der Agent-Konfiguration - danach stehen dietokensave_*-Tools in Claude Code bereit.- Nach externen Änderungen, vor allem nach einem
git pull:tokensave sync. Sonst arbeitet der Graph mit veraltetem Stand. tokensave upgradeholt neue Versionen von GitHub.
Punkt 4 ist der einzige, den man sich wirklich merken muss - warum, steht weiter unten.
Nachgemessen: der Benchmark
Behauptete Ersparnisse sind das eine, reproduzierbare Messungen das andere. tokensave bringt dafür einen eigenen Befehl mit: tokensave bench stellt zehn Standardfragen an das aktuelle Projekt („Wie wird die Konfiguration geladen?", „Wo werden Fehler definiert und weitergereicht?", …) und vergleicht die Token-Kosten der Graph-Antwort mit der Baseline, also dem Lesen der relevanten Dateien.
Das Ergebnis in meinem Website-Projekt: 94 Prozent mittlere Ersparnis - 53.900 Tokens für die Baseline gegenüber 3.000 Tokens über alle zehn Fragen, pro Frage also grob 5.000 bis 6.000 Tokens klassisch gegen rund 300 per Graph. Wer es noch konkreter mag: tokensave discover analysiert die eigene Claude-Code-History und zeigt, welche vergangenen Navigationsschritte eine Graph-Abfrage billiger erledigt hätte.
Was es im Alltag bringt
Die Ersparnis ist keine Schätzung, sondern steht im eingebauten Zähler: über 12 Millionen Tokens quer über alle meine Projekte, Tendenz täglich steigend. Angenehmer Nebeneffekt: Antworten auf Codefragen kommen spürbar schneller, weil weniger Kontext durchs Modell muss - und sie werden eher präziser, aus genau dem „Lost in the Middle"-Grund von oben.
Die Nuance Prompt-Caching
Ein Einwand liegt nahe: Die API-Anbieter cachen doch ohnehin. Stimmt - beim Prompt Caching wird ein unveränderter Kontext-Präfix zwischengespeichert, Cache-Lesezugriffe kosten nur rund ein Zehntel des normalen Eingabepreises. Das relativiert das „bei jeder Anfrage neu bezahlt" aus dem Token-Exkurs, ersetzt tokensave aber nicht, denn die beiden Hebel wirken an verschiedenen Stellen: Caching verbilligt das Wiederlesen desselben aufgeblähten Kontexts - und schon eine kleine Änderung am Anfang macht den Cache ungültig. tokensave sorgt dafür, dass der Kontext gar nicht erst aufgebläht wird. Das eine ist ein Rabatt auf die große Rechnung, das andere macht die Rechnung klein. In der Praxis profitiert man von beidem gleichzeitig.
Wo es hakt
Der größte Stolperstein ist die Veralterung. Ändert sich der Code außerhalb der eigenen Session - klassischerweise durch ein git pull -, arbeitet der Graph mit altem Stand weiter. Immerhin: Aktuelle Versionen erkennen Commits seit dem letzten Sync und warnen im Status-Check explizit („1 commit since last sync"). Wer die Warnung übersieht, bekommt aber weiterhin still veraltete Antworten, bis tokensave sync läuft - und sucht den Fehler bis dahin an der falschen Stelle.
Dazu kommen zwei kleinere Einschränkungen: Die Abfragen sind pro Aufgabe gedeckelt, komplexe Fragen muss man also bündeln statt einzeln durchzuprobieren. Und tokensave beantwortet nur Fragen zur Code-Struktur - für Websuche, Dokumentation oder alles jenseits des Repositorys bringt es naturgemäß nichts.
Lokal, aber nicht netzwerkfrei: der Worldwide Counter
Der Code-Graph, die Suche, die Embeddings - all das läuft lokal, kein Quellcode verlässt den Rechner. Ganz netzwerkfrei ist tokensave trotzdem nicht, und das gehört in jede ehrliche Bilanz: Standardmäßig meldet es die gesparte Token-Zahl an einen öffentlichen „Worldwide Counter". Übertragen wird dabei ein einzelner HTTP-POST mit einer Zahl (etwa {"amount": 4823}), das Herkunftsland wird serverseitig aus der IP abgeleitet - kein Code, keine Dateinamen, keine User-ID. Dazu kommen Versionsabfragen gegen die GitHub-Releases-API für upgrade.
Beides ist dokumentiert und abschaltbar (tokensave disable-upload-counter). Ich habe den Upload bewusst aktiv gelassen - auch weil der globale Zähler ein hübsches Argument für das Tool selbst ist: Er steht aktuell bei rund 17,6 Milliarden gesparten Tokens über alle Installationen weltweit.
Meine Erfahrung
Ein Tool, das sich in die Agent-Konfiguration einträgt und bei jeder Codefrage mitliest, bekommt bei mir keinen Vertrauensvorschuss. Vor dem produktiven Einsatz habe ich mir deshalb Repo-Metadaten, Commit-Historie und Laufzeitverhalten angesehen - das Ergebnis war ein aktiv gepflegtes Open-Source-Projekt, dessen Netzwerkverhalten genau dem entspricht, was die Dokumentation angibt: der Zähler-Upload, die Versionschecks, sonst nichts.
Seitdem ist genau das passiert, was man sich von so einem Tool wünscht: nichts. Kein Vorfall, keine Überraschung - nur ein Zähler, der wächst, und Codefragen, die schneller beantwortet sind. Inzwischen ist tokensave in all meinen Projekten das erste Werkzeug für Code-Recherche.
Fazit
tokensave ist kein Wundermittel, sondern ein gut durchdachtes Spezialwerkzeug: Es macht eine Sache - Codefragen ohne Volltext-Lesen beantworten - und die macht es messbar gut, bei mir mit 94 Prozent Ersparnis im reproduzierbaren Benchmark und über 12 Millionen gesparten Tokens im Alltag. Die Grenzen sind bekannt und beherrschbar: Der Graph sieht nur statische Struktur, er will nach externen Änderungen gesynct werden, und wer Wert auf komplette Netzwerk-Abstinenz legt, schaltet den Zähler-Upload ab. Wer regelmäßig mit KI-Assistenten in größeren Codebasen arbeitet, sollte es sich ansehen. Nur das tokensave sync nach dem git pull - das sollte man sich wirklich merken.
Quellen
- tokensave auf GitHub: github.com/aovestdipaperino/tokensave - Quellcode, Lizenz, Dokumentation des Worldwide Counters und Commit-Historie
- Liu et al. (2023): Lost in the Middle: How Language Models Use Long Contexts - Studie zur Abrufgenauigkeit in langen Kontexten
- Anthropic: Prompt-Caching-Dokumentation - Funktionsweise und Preisstruktur des Präfix-Cachings